8月24日,NVIDIA在Hot Chips 2026期间宣布,交互式AI推理加速器Groq 3 LPX进入全面量产。该产品是Vera Rubin平台的扩展件,与Vera Rubin NVL72配合使用,专门提升Token生成速率,面向智能体AI这类需要高频交互的推理负载。Nebius成为首个采用该加速器的AI云厂商,计划将其部署到Nebius Token Factory生产推理平台;Groq公司自身也宣布将作为最早一批采用者之一,与Dell Technologies合作部署。智能体AI给推理系统带来两个
关键字:
NVIDIA
Groq3LPX
VeraRubin
AI推理
Token生成
智能体AI
数据中心
科技行业如今紧盯一项核心指标:超大规模云厂商与政府机构所囤积 GPU 的绝对数量。一种普遍观点认为,谁手握最多处理器,谁就能赢得下一轮科技革命,也就是 AI 竞赛。这种想法并不陌生,它复刻了过往多轮技术热潮 —— 当时依靠硬件扩产就能攻克各类工程难题。但只盯着显卡,会忽略一个更大的现实问题:如今全球高带宽内存(HBM)供给短缺。即便手握顶级计算集群,如果内存不足,集群也只能空转,无法跑满性能,只能等待数据载入。IDC 相关博客文章指出,全球半导体行业正遭遇前所未有的内存芯片缺口,硬件增长严重受制于原材料供
关键字:
内存短缺
AI推理
2026年8月5日,上海 – Sandisk闪迪公司在FMS 2026 (FMS 26) 现场展示了创新NAND技术,为下一阶段的人工智能(AI)基础设施发展注入动力。随着模型规模扩大、上下文窗口延长以及智能体应用爆发,容量、带宽和能效正面临空前的需求,内存与存储对AI的性能和大规模部署的重要性也因此日益凸显。闪迪提供先进的NAND闪存技术,助力客户扩展AI推理能力,以满足数据中心、云环境以及AI驱动型工作负载不断演进的需求。闪迪公司首席产品官Khurram Ismail表示:“AI基础设施已迈入新发展阶
关键字:
闪迪
Sandisk
FMS2026
NAND技术
AI推理
2026 年秋季,AI推理领域将迎来一轮重大变革。推理如今已是人工智能最核心的负载,想要做好推理,仅靠高性能芯片远远不够,还需要全新架构、内存方案带来的系统性创新。
关键字:
微控制器
微处理器
人工智能
AI推理
在航空航天、防务等功耗受限且任务关键型场景下部署AI推理,需要能够平衡性能、效率、可靠性与开发便捷性的解决方案。为更好地应对这些挑战,Microchip Technology Inc.(微芯科技公司)今日宣布正式发布 VectorBlox™ 3.0 加速器软件开发工具包(SDK),帮助简化基于 FPGA 的AI部署并加快产品上市。VectorBlox 3.0 SDK及相关 CoreVectorBlox 知识产权(IP)均免费向开发者提供,旨在提供一体化工具链,简化在 PolarFire® FPGA 及片上
关键字:
Microchip
加速器
AI推理
SDK
英伟达宣布,其搭载机密计算技术的 GPU 已应用于苹果私有云计算(Private Cloud Compute,PCC)的机密推理场景。苹果正将该系统从自有数据中心拓展至谷歌云,此举使英伟达 Blackwell 架构 GPU 融入硬件安全体系,为部分服务器端苹果智能(Apple Intelligence)工作负载提供支撑。英伟达机密计算拓展苹果私有云计算能力苹果打造私有云计算(PCC),旨在处理设备端模型无法承载的高负载 AI 请求,同时保障用户数据免受运营商及管理员访问。苹果在安全更新中表示,谷歌云部署方
关键字:
英伟达
机密计算
苹果智能
私有云计算
谷歌云
AI推理
Blackwell架构
尽管我们十分关注计算引擎、网络芯片与存储设备,但最终核心仍在于系统架构师如何整合这些组件,将其打造成能够实现具备经济、社会乃至生物领域价值的、可落地的专用系统。部分系统架构师倾向自主整合业内顶尖组件,以在协同设计层面掌握一定主动权;也有部分客户只希望采购可随业务增长灵活扩容的完整整机系统,实现最快部署投产。韩国 AI 芯片初创企业 Rebellions AI 下一阶段的扩张核心,正是面向这类整机采购客户。考虑到该公司立志在本土市场之外大量销售 AI 加速芯片与完整系统,这一布局十分契合其战略。对于那些尚未
关键字:
Rebellions
AI
AI推理
整机系统
当前,AI工作负载日趋多样与复杂,越来越多的企业与机构正根据自身需求灵活选择解决方案。由此,也带动了对异构基础设施的需求,而这需要多元算力、内存、网络以及软件基础上的一致性,以支撑数据中心层面的大规模推理部署。近日,SambaNova 宣布与英特尔启动一项为期多年的合作计划,即基于英特尔® 至强®(Intel® Xeon®)平台的基础设施,为全球AI原生企业、模型提供方、企业客户及机构提供高性能、具备成本效益的AI推理解决方案。与此同时,英特尔资本也将参与SambaNova的E轮融资。对于那些在AI工作负
关键字:
英特尔
SambaNova
至强处理器
AI推理
致力于将AI技术应用于复杂环境中数据的Cloudera 今日宣布,将 Cloudera AI Inference 和 Cloudera Data Warehouse with Trino 扩展至本地部署环境,使客户能够直接在其数据中心内利用先进的 AI 和分析功能。 同时宣布增强 Cloudera Data Visualization 的 AI 和分析功能,从而简化跨云、边缘和数据中心环
关键字:
Cloudera
AI推理
鉴于谷歌TPU这个话题极为重要,我们发布了一篇全面的深度分析,不仅是技术概述,还包括对谷歌TPU的战略和财务报道。
关键字:
谷歌
TPU
AI推理
芯片
纵观整个电子行业,往更高密度的集成电路发展无疑是主流趋势。相对于逻辑电路追求晶体管密度提升,类似于FLASH NAND这样的非易失性存储还需要考虑到电子的稳定保存,单纯的提升制造工艺并不能很好的解决所有存储问题,在稳定保存的前提下追求更高的存储密度才能确保新技术、新产品可持续发展,存储单元向上要空间成为顺理成章的事情,因此在SLC(Single-Level Cell)之后才有MLC(Multi-Level Cell),TLC(Triple-Level Cell),以及日渐成为主流的QLC(Quad-Lev
关键字:
AI推理
QLC
NAND Flash
在MWC 25上海期间,英特尔展示了一幅由英特尔锐炫™ Pro B系列GPU所驱动的“实时响应、安全高效、成本可控”的边缘AI图景。英特尔客户端计算事业部边缘计算CTO、高级首席AI工程师张宇博士英特尔客户端计算事业部边缘计算CTO、高级首席AI工程师张宇博士在MWC AI终端峰会上指出,边缘将崛起为AI落地的核心场景,而英特尔精准捕捉和把握这一趋势,依托包括英特尔锐炫™ Pro B系列GPU和英特尔酷睿™ Ultra 200H系列处理器在内的创新产品与生态布局,让AI真正在数据产生之地落地生根。AI的到
关键字:
英特尔
锐炫
显卡
AI推理
AI推论快速成长,QLC NAND Flash成为企业级储存解决方案的新宠。 相较于传统的TLC NAND,QLC具备更高存储密度与更低成本,适合以读取为主的AI推论工作负载。 法人分析,台厂如群联、威刚、宇瞻等存储器模组厂,有望从中受惠。根据调研机构预测,2025年QLC NAND产能将达250.48亿Gb,占NAND总产能的22.2%,渗透率逐步提升。AI推论服务器主要负责分析以及处理大量数据,而这类应用访问模式以读取为主,写入频率相对较低,正好契合QLC SSD的特性。QLC NAND有更高存储密度
关键字:
AI推理
QLC
NAND Flash
根据TrendForce集邦咨询最新研究,2024年全球AI
服务器(Server)出货量受惠于CSP、OEM的强劲需求,年增幅度为46%。国际形势、DeepSeek效应、英伟达GB200/GB300
Rack供应链整备进度等将成为影响2025年AI Server出货量的变量,TrendForce集邦咨询据此提出三种情境预估。第一种为基础情境(base
case),研判发生的机率最高。近期Microsoft、Meta、Amazon、Google等主要CSP业者皆宣布,扩大今年对云端或AI基础设
关键字:
AI Server
DeepSeek
AI推理
TrendForce
集邦咨询
2024 年秋季,边缘计算解决方案提供商研华科技推出 AIR-310,这是一款搭载 MXM GPU 卡的紧凑型边缘人工智能推理系统。AIR-310采用第12/13/14代英特尔酷睿65W处理器,通过NVIDIA Quadro 2000A GPU卡在1.5U高度机箱(215 x 225 x 55毫米)内提供高达12.99 TFLOPS的可扩展AI性能。尽管体积小巧,但它提供了3个 LAN 端口和4个 USB 3.0 端口的多功能连接,可无缝集成用于视觉 AI 应用的传感器和摄像头。该系统包括智能风扇管理,工
关键字:
研华
AIR-310
AI推理
全球AIoT 平台与服务供应商研华 (2395, TW) 隆重推出搭载第 13 代 Intel Core 移动处理器的紧凑型边缘 AI 推理系统 AIR-150。尽管体积小巧(156 x 112 x 60 mm),但它却拥有 Hailo-8 AI 加速器提供的 26 TOPS AI 计算能力。AIR-150在连接性方面毫不逊色,提供以应用为中心的 I/O,包括 COM、USB、LAN 和 M.2 E-Key,便于无缝扩展和连接外围设备。它的工作温度范围宽达 -20 至 60°C,并符合重工业 IEC 标准
关键字:
研华
Hailo-8
AI推理
今日,MLCommons公布针对 60 亿参数大语言模型及计算机视觉与自然语言处理模型GPT-J的 MLPerf推理v3.1 性能基准测试结果,其中包括英特尔所提交的基于Habana® Gaudi®2 加速器、第四代英特尔®至强®可扩展处理器,以及英特尔®至强® CPU Max 系列的测试结果。该结果显示了英特尔在AI推理方面极具竞争力的表现,并进一步加强了其对加速从云到网络到边缘再到端的工作负载中大规模部署AI的承诺。英特尔执行副总裁兼数据中心与人工智能事业部总经理Sandra Rivera表示:“正如
关键字:
MLCommons
英特尔
AI推理
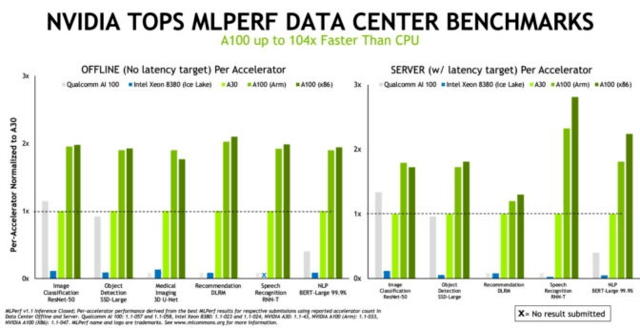
根据近日发布的基准测试结果,NVIDIA在使用x86及Arm CPU进行AI推理时取得了最佳成绩。这是NVIDIA连续第三次在MLCommons推理测试中创造性能和能效纪录。MLCommons是一家成立于2018年5月的行业基准测试组织。 这场测试是第一次在Arm系统上进行数据中心类别的测试,这使用户在部署AI这一目前最具变革性的技术时有了更多的选择。 领先的性能 在最新一轮测试中,由N
关键字:
NVIDIA
AI推理
Arm服务器
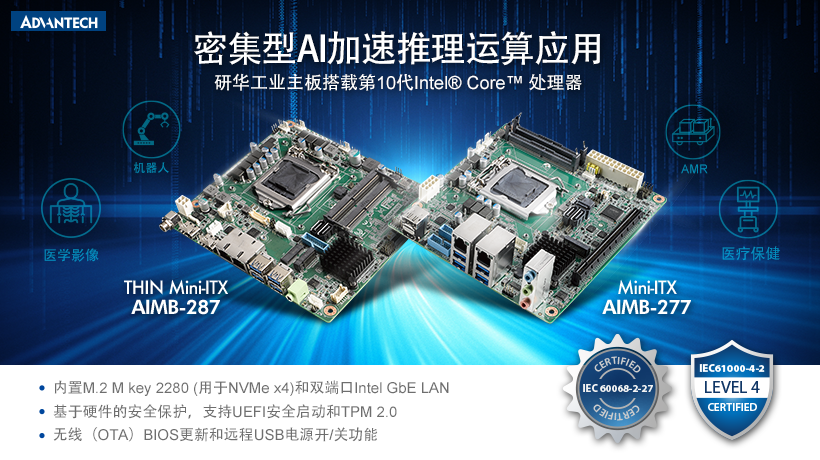
研华推出两款搭载第十代 Intel Core 处理器的创新型工业主板,即AIMB-277和AIMB-287主板,分别采用Mini-ITX和Thin Mini-ITX尺寸设计,可将工厂自动化、医疗和自助服务应用中的AI解决方案的整点运算能力提升31%。NvMEx4出色性能 增强AI性能研华AIMB-277/287工业主板支持10核,最高可达64GB的DDR4-2933 MHz,并运用M.2 M key NVMe x4来适应极高的数据速率和严苛要求的密集型AI加速推理运算应用。多种认证满足不同工业环境要求研华
关键字:
研华
工业主板
AI推理
工业自动化
医疗
自助服务
AIMB-277
AIMB-287
ai推理介绍
您好,目前还没有人创建词条ai推理!
欢迎您创建该词条,阐述对ai推理的理解,并与今后在此搜索ai推理的朋友们分享。
创建词条
关于我们 -
广告服务 -
企业会员服务 -
网站地图 -
联系我们 -
征稿 -
友情链接 -
手机EEPW
Copyright ©2000-2015 ELECTRONIC ENGINEERING & PRODUCT WORLD. All rights reserved.
《电子产品世界》杂志社 版权所有
京ICP备12027778号-2 北京市公安局备案:1101082052 京公网安备11010802012473

 京ICP备12027778号-2 北京市公安局备案:1101082052 京公网安备11010802012473