
CAST将完整TCP/IP协议栈硬件化,速率达100Gbps
 加入技术交流群

 收藏
CAST 推出了TCPIP‑100G可综合 IP 核,专为 ASIC 与 FPGA 实现全硬件 TCP/IP 协议栈。该 IP 核最高可实现 100Gbps 收发速率,无需依赖主机处理器。这一点至关重要:它并非仅做校验和计算、或是只加速部分耗时操作而把连接管理留给软件的网络接口模块。CAST 表示,该 IP 核可自主完成 TCP 连接的建立、维护与关闭,在数据通路内部处理重传、流量控制与拥塞控制。
对于集成该 IP 的系统,其编程模型相对简单。固件将网络与连接参数写入控制寄存器,再将应用数据流入、流出该 IP 核。TCPIP‑100G 完成全部协议处理,把数据流转换为可靠、有序的 TCP 流量。它既可以作为客户端,也可以作为服务器;综合编译时可配置最高支持32768 个并发会话。会话数量在综合阶段配置,设计人员可以在芯片面积、内存开销和连接密度之间做权衡,无需为未使用的连接能力付出硬件成本。
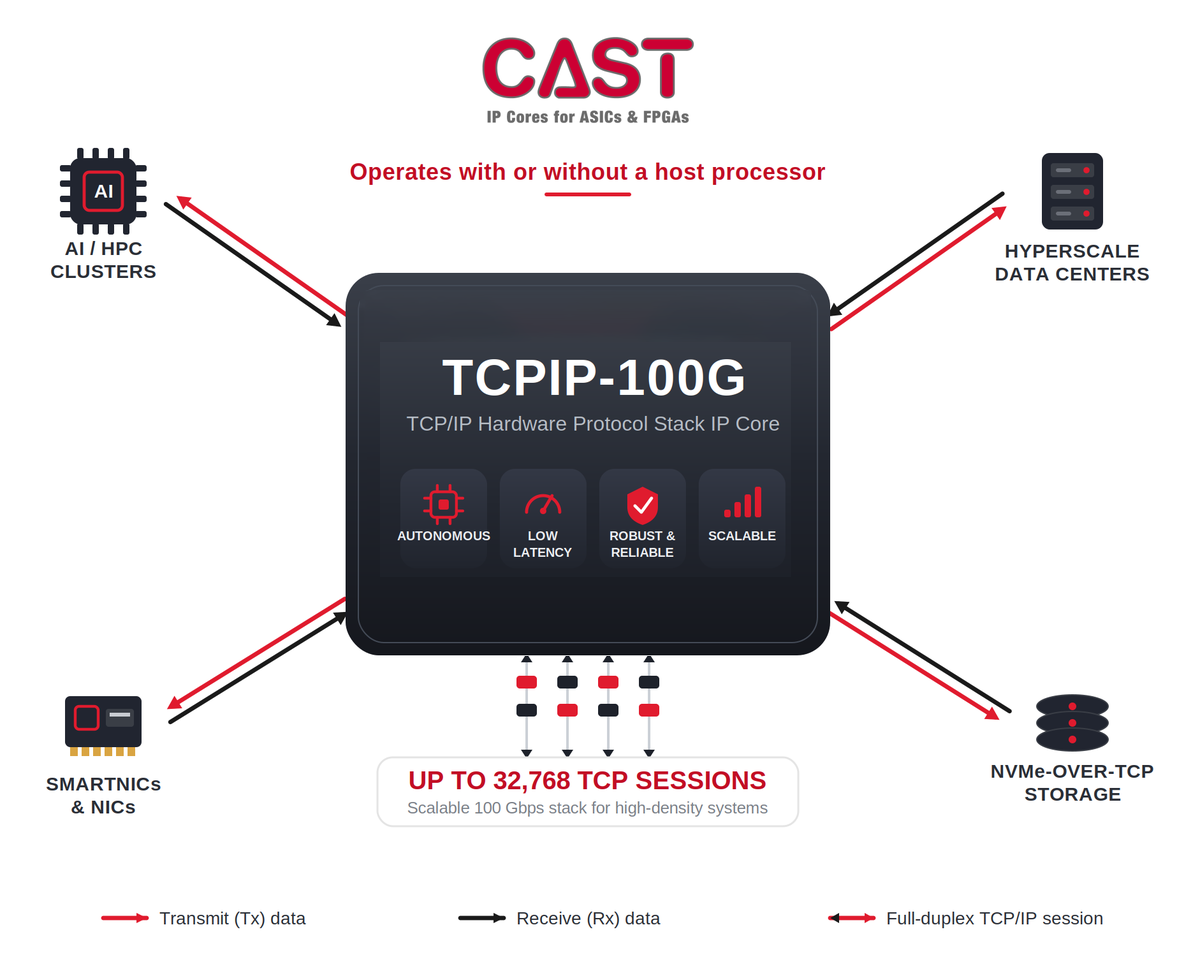
基础配置包含:IPv4、ARP 及 ARP 缓存、ICMP 应答、IEEE 802.1Q VLAN 标签、校验和生成与校验、巨帧与超巨帧。可选扩展功能包括 DHCP 客户端、TCP 乱序报文重组、带 IGMPv3 组播功能的 UDP 硬件协议栈;还有独立通路,可将其他 IP 流量转发至外部系统。综合以上功能,该模块更接近一套自主网络子系统,而非简单的传输层加速器。
CAST 还提供两种重要架构模式选择:直通模式(Cut‑through),无需缓存并校验完整数据包,就开始输出有效载荷,最大限度降低延迟与内存占用;存储转发模式(Store‑and‑forward),等待报文校验完成后再有序输出,优先保障数据完整性与行为可预测性。运行时可配置 MAC/IP 地址、过滤规则、重传策略、TCP 窗口大小、最大报文段长度,同一套硬件实现可适配多种业务负载。
集成采用业界通用 AMBA 接口:512 位 AXI4‑Stream 数据通路、32 位 AXI4‑Lite(可选 APB3)控制接口、2048 位 AXI4 外部内存接口。报文处理与寄存器访问分属独立时钟域。该 IP 核不绑定特定外部内存器件、内存控制器、以太网 MAC 与 PHY;也可以预先集成 CAST 或第三方的 MAC IP。交付物包含可综合 Verilog RTL、目标 FPGA 网表、测试激励、脚本与文档;UVM 验证环境为可选组件。
技术价值解读
100Gbps 链路,扣除协议开销前的数据速率可达 12.5GB/s。报文处理、维护数千个 TCP 状态机、丢包恢复、拥塞窗口管控会消耗大量 CPU 算力,还会带来调度抖动。把完整协议栈下沉至专用硬件逻辑,可让延迟更确定,释放处理器内核处理业务应用,降低软件网络带来的数据搬运与指令开销。
该优势适用于 AI 与高性能计算集群、超大规模数据中心基础设施、智能网卡(SmartNIC)、NVMe‑over‑TCP 存储。以上场景中,网络处理往往成为加速器、存储、内存系统之间的性能瓶颈。无主机依赖的协议栈,还可以用于不带通用 CPU 的精简终端设备;以及即便主机软件受限制,仍要持续转发流量的网络设备。
不过产品通告并未公布实测落地数据,实际性能取决于实现结果:FPGA 资源占用、ASIC 面积、工作时钟、外部内存带宽、功耗、不同报文长度下的实际吞吐、连接频繁创建销毁(connection churn)、丢包 / 乱序条件下的表现。硬件 TCP 是以牺牲部分软件灵活性换取处理效率,因此标准迭代、安全策略、极端网络场景都需要细致的系统设计。即便如此,TCPIP‑100G 仍是重要的技术选项:高可靠以太网网络成为可配置的硬件构件,而不再是依附产品之上的软件负载。




评论