
CFET:打造更优异的互连结构
 加入技术交流群

核心要点
英特尔、三星、台积电、IBM 采用不同方式连接纳米片堆叠层,但全部会采用背面通孔实现背面供电。
CFET 的核心关键:无缺陷外延生长、原子层沉积(ALD)介质层、功函数优化金属,还可能用到层转移技术。
虚拟仿真加速技术路线探索、工艺集成与良率提升,同时节省真实硅片流片的时间与成本。
短短数年内,头部器件厂商即将推出互补场效应晶体管(CFET)。该技术将 N 型与 P 型晶体管上下堆叠,相比当前横向纳米片器件,晶体管密度几乎翻倍。新架构预计可将集成密度提升 40%,性能提升 50%,能效最高可提升 70%。
优化 CFET 栅堆叠的材料与工艺流程本身就是巨大工程。下一个重大挑战,是完成晶体管之间、晶体管与晶圆正反面之间全部必需的垂直信号与电源互连。
距离工艺正式量产认证还有数年,但早期研究显示,台积电、英特尔、三星、IBM 的 CFET 实现方案略有差异。例如 IBM 采用顺序工艺,先完整制造底层晶体管,上层晶体管做少量偏移错位排布。
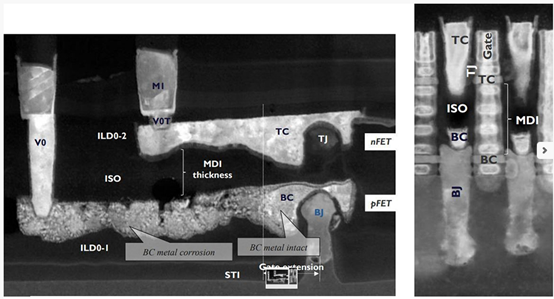
其余多数厂商选择单片集成工艺,整套堆叠结构同步制备。英特尔同时研究单片工艺与混合衬底方案:为 N 管、P 管分别选用最优硅衬底,改善历史上性能偏弱的 P 管。台积电采用背面栅接触,搭配两种垂直接触插头,用于连接 SRAM 存储单元内部不同功能层。三星开发了新型介质堆叠结构,实现两组栅极区域隔离。
在上述各家技术路线中,多物理场仿真在新结构的路线探索与良率优化中的地位越来越重要。潜在风险点众多:哪怕仅几纳米的材料偏移,就会造成毁灭性良率损失;微米‑纳米尺度的晶圆翘曲,也会大幅劣化器件性能。
“纳米片器件尺寸极小,几乎容不下任何工艺偏差。” 泛林半导体 Semiverse Solutions 董事总经理 Joseph Ervin 表示,“器件发生形变就会引发故障。哪怕仅 2 纳米的对准偏差,也会给制造带来严重问题。”
业内其他人士也持相同观点。“每一项技术创新,都必须兼顾翘曲形变与可靠性。” 英特尔晶圆代工装配测试技术研发副总裁 Lalitha Immaneni 称,“EDA 生态正在开发各类多物理场仿真工具,正是出于这一考量。我们必须提升预测能力。当面对成千上万套设计时,可以建立数据库;在设计各个里程碑节点,无论是完成度 90% 还是 60%,都要能够给出方案,例如‘铜密度分布有四五种可选方案,其中这两项最优’。如果流片前一周才告知复杂产品存在翘曲、铜密度波动过大,为时已晚。”
背面供电技术最早在 2nm 节点引入,在带来增益的同时增加工艺复杂度,也更容易引发翘曲、工艺波动与缺陷。“台积电、英特尔等企业的实践表明,该技术需要先进晶圆键合、背面减薄、极高精度的正反面对准工艺。” 布鲁尔科学(Brewer Science)高级技术专家 Douglas Guerrero 指出,“全新集成要求显著提升制造复杂度,同时器件对工艺波动更加敏感。”
新型晶体管架构首先在先进逻辑芯片落地,之后技术会逐步下沉到其他产品平台。“FinFET 带来第一代 3D 器件效果;如今环绕栅(GAA)技术问世,我们持续向全三维晶体管演进。” 三星集团总裁兼 CTO 宋在赫(Jaihyuk Song)在近期演讲中表示,“三星首先将该类技术用于逻辑器件,之后拓展至 DRAM,再到 NAND 闪存。在三大核心器件落地这套创新,不仅实现性能提升,还构建单元库套件,在全公司范围内形成技术协同。”
直观来看,晶体管上下堆叠,横向宽度理应缩减 50%;但实际缩减幅度会更小,需要预留空间,实现上下管互连、晶体管与上层信号线、下层电源线的连接。即便如此,CFET 依旧有望将标准单元高度从约 5T(5 倍接触节距)压缩至 4T 甚至更低,具体取决于工艺。密度提升在 SRAM 设计中价值尤为突出,可由传统 6T 架构演进为紧凑的 4F² 单元。
纳米片晶体管工艺流程与关键要点
为制备电流流通的纳米级硅片沟道,首先通过外延工艺生长硅 / 硅锗异质堆叠,堆叠层数对应纳米片数量。例如,实现 3 层纳米片 N 管叠 3 层纳米片 P 管(或反向堆叠),至少需要 6 层硅、5 层硅锗。硅锗为牺牲层,通过选择性去除(也称沟道释放),形成悬空硅桥;两端区域则构成源极与漏极。
芯片厂商通过增加纳米片数量提升驱动电流,但工艺复杂度随之陡增,3 层纳米片晶体管制造难度远高于 2 层。行业普遍将 N 管置于上层、P 管置于下层,让 P 管借助第一层硅 / 硅锗堆叠产生的应力,提升载流子迁移率。
CFET 纳米片沟道宽度约 11‑25nm,厚度仅数纳米。纳米片外围沉积高 k 栅介质,再完整包覆金属栅极,二者均通过原子层沉积(ALD)制备。GAA 与 CFET 工艺的一大区别,是新增中间介质隔离层(MDI),实现上层栅极与下层栅极电气隔离。
例如三星制备栅节距 42nm 的 CFET,两种晶体管均采用三层堆叠沟道;其 MDI 堆叠包含三种不同锗浓度的介质层。“为实现 N 管、P 管栅偶极子与功函数金属的独立调谐,我们在上下两层栅极之间引入三层外延层作为 MDI。” 三星电子研发中心首席科学家黄东厚(Hwang Dong‑hoo)在演讲中表示。“用于垂直栅极图形化的 MDI 结构,是分别为 N/P 管配置适配栅偶极子与栅金属的关键支撑技术。”
MDI 在虚拟栅制备之后生成,完整工艺流程如下:
晶圆准备
浅沟槽隔离(STI)制备
虚拟栅成型
底层源漏刻蚀
底层源漏外延生长
源漏隔离制备
上层源漏外延生长
环绕栅(GAA)结构成型
替换金属栅工艺
中端互连(MOL)制备
后端互连(BEOL)集成
台积电则强调 CFET 技术的变革价值与设计自由度。“除微缩收益之外,垂直堆叠架构带来灵活的正面、背面引脚接入全新可能性。该技术从底层重塑设计体系,实现更优的互连布线与供电方案。” 台积电研发路线与器件架构创新总监廖思雅(Szuya Liao)解释道。
台积电工艺流程:
纳米片堆叠制备
浅沟槽隔离(STI)制备
虚拟栅图形化
N/P 源漏外延集成
第 0 层层间介质(ILD‑0)平坦化
纳米片切割隔离
硅纳米片沟道释放
栅堆叠与多阈值电压(Multi‑Vt)集成
中端互连(MOL)、后端互连(BEOL)集成
背面中端互连、后端互连集成
在栅堆叠环节,台积电采用偶极子图形化工艺,为 GAA 与 CFET 实现高低阈值电压调谐。在高 k 栅介质界面引入超薄金属‑氧化物偶极层(氧化镧、氧化铝等),无需更换栅金属,依靠静电效应改变晶体管功函数。“多阈值电压是核心平台特性,设计师可在单颗芯片混合部署不同速度‑功耗特性晶体管,实现性能与能效优化,例如高阈值管用于低功耗场景,低阈值管用于高速场景。该能力对复杂 AI 与移动设备系统至关重要。” 廖思雅表示。
N 管、P 管在不同硅衬底上可以实现最高载流子迁移率,厂商可选用不同衬底充分挖掘性能。英特尔 N 管沿用常规 (100) 硅衬底;P 管采用 (110) 晶向硅衬底,再通过层转移工艺完成高精度键合。工艺流程:器件晶圆临时键合至载体晶圆,将载体与目标有源晶圆键合,再高精度剥离载体晶圆。
最终实现:(110) 衬底 P 管堆叠在 (100) 衬底 N 管之上,P 管有效迁移率提升 3 倍。英特尔栅节距 45nm 的 2×2 RibbonFET 器件搭载直接背面供电通孔,晶体管共用同一根栅极;为规避分栅方案的复杂度,采用晶体管删减技术,再通过设计‑工艺协同优化补偿由此带来的性能损失。
IBM 的 CFET 方案已授权给 Rapidus,采用顺序工艺,晶体管做错位排布。错位结构相比严格垂直堆叠,信号、电源到晶体管的互连路径更加直接。上层纳米片偏移 10nm,单元高度缩减 20nm。该设计可依托现有光刻设备完成图形化:底层有源区间距 50nm,上层有源区间距 30nm,栅切割厚度 20nm;结合其余互连结构,相比非堆叠纳米片,单元高度缩减 40%。
工程师对比不同架构的工艺窗口,筛选出抗工艺波动能力更强、缺陷更少、综合性能更优的方案。“设计工程师清楚最终想要的器件规格,但难点在于如何制造出来,这正是晶体管研发的创新与工艺艺术所在。”Joseph Ervin 说,“基于物理模型的仿真是很好的起点。工程师对比 N 管在上 / P 管在下、P 管在上 / N 管在下两种堆叠,评估各类集成方案。”
仿真也用于技术定型后的优化。“行业当下热点:基于标准工艺条件,给每道工艺注入变量扰动,推演最终结果。”Ervin 介绍,“我们借助机器学习扫描标准工况周边全部参数空间,输出每道工序的工艺窗口与波动范围。结合设备实际能力,例如沉积厚度、外延刻蚀深度、材料刻蚀选择比,直接输入模型。”
CFET 要求原子级工艺控制
现有纳米片(GAA 环绕栅)晶体管制造的核心难点,早已不止纳米片本身制备;还需要在整片 300mm 晶圆上,对关键尺寸、间距、沟道释放(硅锗去除)、栅极制备、接触孔实现极致精密管控。
此外,虽然部分 GAA 器件已经采用背面供电,根据 imec 路线图,全部 CFET 工艺都将采用背面供电(见图 1)。有意思的是,尽管很多观点认为特征尺寸微缩已经走到尽头,但路线图显示,借助高 NA‑EUV 光刻,金属节距会继续缩小,只是微缩幅度相比历史有所放缓。

图 1:路线图显示 CFET 约 2031 年在 A7 节点实现量产,关键尺寸缩小至 18nm 以下。来源:imec
EUV 光刻单位面积光子数量有限,带来两大难题:光子吸收波动,引发边缘粗糙度(LER)、线宽粗糙度(LWR)以及随机缺陷。同时为实现高深宽比刻蚀,图形高度增加,图形坍塌风险上升。
EUV 底层材料可以改善该问题。“EUV 底层材料增强光刻胶附着力,抑制图形坍塌,提升图形保真度,对光刻性能至关重要。”Brewer Science 的 Douglas Guerrero 表示,“先进底层材料还可降低线条边缘、线宽粗糙度;部分场景优化光刻胶化学环境,抑制随机缺陷,降低曝光剂量需求。”
离子束刻蚀(IBE)也可以刻除粗糙边缘,改善 LER/LWR。IBE 发射高度准直离子束轰击光刻胶图形,束流倾斜角度需要针对工艺做优化。
EUV 光刻与刻蚀需要多层协同优化。“图形转移阶段广泛使用含硅硬掩模。EUV 曝光显影后,光刻胶图形转移至硅硬掩模,再向下转移至下层碳层。”Guerrero 介绍,“光刻胶、硅硬掩模、碳层刻蚀选择比各不相同;通过刻蚀化学体系选型,可以精准控制图形转移,提升关键尺寸控制、图形保真度,赋予工艺集成更高灵活性。”
IBM 已经完成高 NA‑EUV 单曝光制备 21nm 金属线的验证,替代第一代 NA‑EUV 复杂的自对准光刻‑刻蚀多重曝光工艺,电学性能表现更佳。
虚拟制造发挥的作用
在真实硅片流片之前,企业依靠虚拟技术对比海量集成方案。“我观察到一个现实:工程师很擅长平面器件思考;进入三维维度,整个逻辑就变得很难梳理。”Ervin 说道,“CFET 是在一套堆叠之上再叠加另一套完全不同的堆叠,复杂度极高。必须依靠计算机,追求原子级仿真精度,微小偏差就会严重影响良率。”
虚拟制造与工艺数字孪生,大幅减少工艺开发所需真实晶圆数量。“AI 与机器学习的一大应用方向,就是构建数字孪生,模拟晶圆厂运行与工艺流程,减少成本高昂、周期漫长的实物实验。”Guerrero 称。
工程师对比不同架构工艺窗口,筛选抗工艺波动强、缺陷少、综合性能更优的方案。“设计工程师知道最终器件目标,但如何落地制造,正是晶体管研发创新的价值。”Ervin 说,“物理仿真模型是很好的起点。工程师对比 N 管在上或 P 管在上,评估各类集成路线。”
仿真也用于技术定型之后的调优。“当下行业热点:以标准工艺条件为基准,对每道工序施加参数扰动,推演结果。”Ervin 表示,“机器学习扫描完整参数空间,输出各工序工艺窗口与波动边界。设备能力参数,例如沉积厚度、外延刻蚀深度、材料选择比,直接输入仿真模型。”
大语言模型同样开始应用。“AI 提供全新探索手段。”Ervin 说,“我们可以提出需求:‘工艺不能出现该类失效,请在集成流程中找到改进方案,实现可量产。’AI 可以辅助回答这类问题,这个领域前景广阔。”
总结
CFET 架构是半导体行业激动人心的技术方向,可大幅提升器件密度,承诺实现 50% 性能提升、70% 功耗下降。台积电、三星、英特尔、IBM 早期论文证明:虽然各家都使用外延、ALD、刻蚀等基础设备,但工艺流程存在差异。行业需要在两类路线之间取舍:带介质隔离的分栅工艺;以及采用晶体管删减、降低寄生效应的共栅工艺。
现有非堆叠纳米片器件,已经逐渐逼近翘曲、对准、工艺波动的容忍极限;CFET 世代的器件必须做到更优。到约 2031 年量产之时,高 NA 光刻技术将更加成熟,简化制造流程。虚拟制造在路线探索与良率提升方面,将发挥比现在更加重要的作用。

评论