
基于大规模并行GPU光栅化器加速计算光刻技术
 加入技术交流群

 收藏
随着半导体制造工艺不断向更先进的纳米制程迈进,计算光刻已从芯片设计的辅助环节,发展成为先进芯片设计的核心支柱。如今,掩模合成、光刻仿真以及光学邻近效应校正(OPC)对计算精度和数据处理吞吐量提出了前所未有的要求。而这些工作流程的核心环节便是光栅化—— 将复杂的几何版图转换为超高分辨率像素网格的过程。
西门子EDA部门近期发布了一份白皮书,提出了应对该问题的创新方案。书中深入剖析了光栅化成为技术瓶颈的原因,以及基于大规模并行 GPU 架构的创新光栅化算法如何破解相关难题,并通过实际性能测试结果,展现了这一创新技术对下一代半导体制造的重要影响。
光刻领域中光栅化的重要性空前提升
光栅化常被与计算机图形学关联,但在电子设计自动化(EDA)领域,它的作用远为关键。在计算光刻中,光栅化后的版图被用于模拟光线透过掩模的传播路径,以及光刻胶在纳米尺度下的反应效果。与图形学应用中仅将像素简单判定为
“开启” 或 “关闭”
不同,光刻领域要求精准的像素部分覆盖率计算,且需严格保留超精细图形之间的连接性。光栅化过程中产生的微小误差,会在仿真和光学邻近效应校正的循环过程中不断放大,最终影响芯片的良率和可制造性。
随着半导体工艺节点向数纳米以下演进,光栅化所需的分辨率呈爆炸式增长,且在迭代式光学邻近效应校正流程中,相同的光栅化操作需要重复执行多次。即便是经过高度优化的基于 CPU 的光栅化器,也难以满足算力需求,光栅化因此成为制约整体运行效率的主要瓶颈。
传统光栅化方法的局限性
多数传统光栅化技术采用二进制覆盖模型,该模型在图形可视化场景中表现良好,但在光刻领域则难以适用。这类方法无法捕捉细微的光强变化,在处理细线条或紧密排布的图形时,还极易产生连接性失真问题。同时,现代芯片版图包含数十亿个多边形,像素评估次数更是高达万亿级,其庞大的数据规模对内存带宽和计算资源造成了巨大压力。
正是在这一背景下,GPU 的优势开始凸显。GPU 的大规模并行处理能力非常适配数据密集型工作负载,但同时也带来了不规则内存访问模式、对数值精度高度敏感等挑战。要将 GPU 成功应用于光刻光栅化,必须设计出以精度优先为核心、适配大规模并行执行的专属算法。

为 GPU 重构光栅化技术逻辑
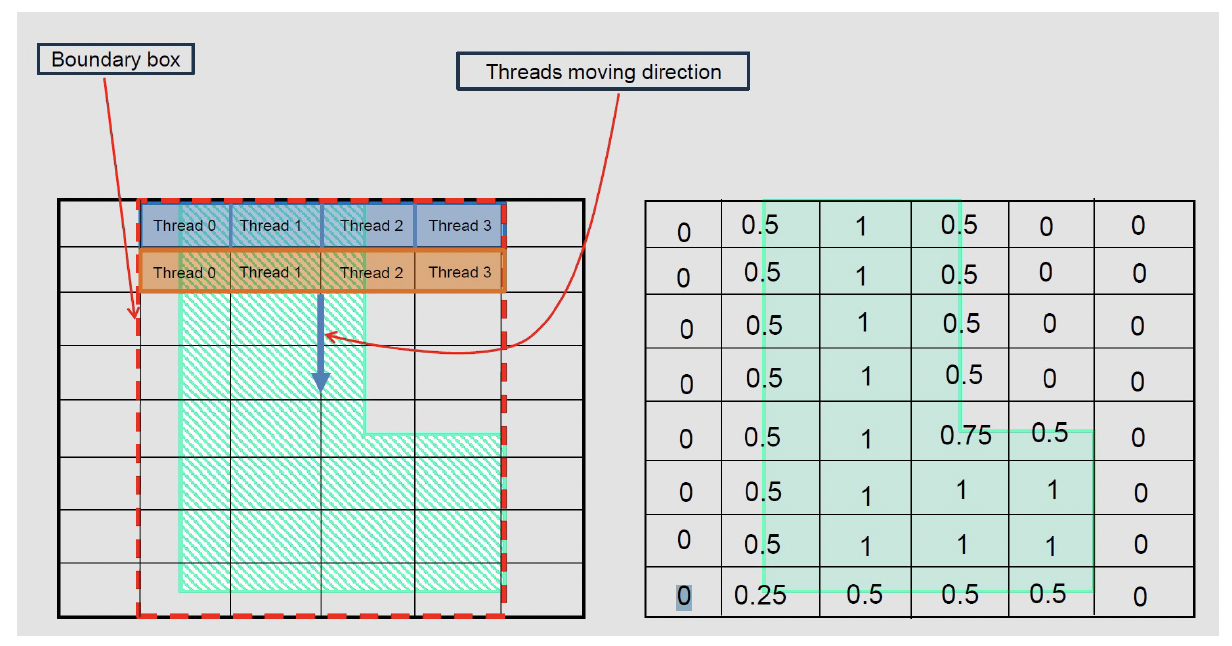
面向计算光刻的 GPU 优化光栅化器,从设计理念上便与传统方案截然不同。该技术不再对多边形进行串行处理,而是将版图按空间维度分解为多个可并行光栅化的独立区域,每个区域对应映射至 GPU 的线程块,使数千个线程能够同时执行像素覆盖率评估。
像素覆盖率的计算采用浮点运算而非近似算法,确保边界相互作用的计算精度达到纳米级别。技术研发中还特别注重保留亚像素级的连接性,避免细线条图形在光栅化过程中发生非预期的断裂。对于曼哈顿几何图形,技术通过简化评估流程提升效率;对于曲线图形,则采用兼具通用性和并行友好性的处理方法。
GPU 光栅化流水线的工作原理
GPU
光栅化流水线的处理始于 CPU 端的预处理阶段:先对版图数据进行解析,并按空间分块归类,再将这些数据块以优化的内存布局传输至
GPU,实现合并式内存访问。在 GPU
端,各数据块被独立处理:几何数据被缓存至共享内存,线程被分配至单个像素或小型像素组,每个线程独立计算其负责的像素处于多边形内部、外部还是边界位置。
处于边界的像素会得到特殊处理:通过解析算法计算与像素相交的多边形边缘,精准求解像素被多边形覆盖的面积比例。当多个多边形作用于同一像素时,通过原子操作实现覆盖率的准确累加。这一设计方案同时实现了高性能和确定性精度
—— 这两大特性在大规模并行系统中通常难以兼得。
该技术基于 CUDA 编程模型开发,在英伟达新一代数据中心 GPU 上运行时表现尤为优异,这类 GPU 能为超高分辨率光栅化提供所需的内存带宽和并发处理能力。
基于英伟达 H100 GPU 的实际性能测试结果
性能基准测试得出了极具说服力的结论:与高度优化的
CPU 光栅化器相比,基于 GPU 的光栅化方案在各类版图处理中均实现了性能的大幅提升。针对以曼哈顿几何图形为主的芯片设计,性能提升最高达
290 倍;即便是处理难度更高的曲线版图,GPU 光栅化器也实现了最高 45 倍的性能提升。
至关重要的是,性能的提升并未以牺牲精度为代价。在所有测试场景中,该方案的计算绝对误差相较于 CPU 基准计算结果均低于 1%。这一精度水平满足了计算光刻领域的严苛要求,也印证了大规模并行处理与纳米级计算精度能够实现兼容。
对电子设计自动化与半导体制造领域的重要意义
GPU
加速光栅化技术的价值,远不止体现在单纯的性能指标提升上。更快的光栅化处理速度能够缩短光学邻近效应校正和掩模合成的周期,让工程师在相同的设计窗口期内完成更多次迭代优化,进而提升校正质量、提高芯片良率、缩短产品上市周期。而高精度的计算能力和图形连接性保留能力,确保了性能提升不会为制造流程引入新的风险。
随着芯片设计中复杂的非曼哈顿几何图形越来越多,且光刻仿真的保真度要求持续提高,基于 GPU 的光栅化技术的可扩展性展现出更高的价值。这一曾经的技术瓶颈,如今已成为光刻流水线中具备可扩展性、面向未来的核心组件。
总结
基于大规模并行
GPU 的光栅化技术,标志着计算光刻工作负载处理方式的重大变革。随着 GPU
架构的持续演进,核心数量不断增加、内存带宽持续提升,该技术的性能优势将进一步扩大。未来的研发工作将聚焦于三大方向:与现有电子设计自动化平台的深度集成、对
CPU-GPU 异构工作流程的支持,以及向更先进光刻模型和三维效应仿真场景的技术拓展。





评论